Kernaussagen
- Datenqualität und Datenzugriff sind zwei verschiedene Themen. In Auswahlprojekten wird meist nur das erste geprüft, während das zweite über den späteren Nutzen entscheidet.
- Je näher KI an operative Prozesse rückt, desto weniger reicht lesender Zugriff. Ab der dritten Stufe entscheidet die Berechtigungslogik darüber, ob eine Anwendung produktiv gehen darf.
- Ein direkter Zugriff auf die Datenbank liefert alle Daten und umgeht dabei die Rechte- und Rollenlogik der Anwendung. Für Prototypen tragfähig, für den Betrieb selten.
- Die Art des Datenzugriffs ist eine Produkteigenschaft und keine Umsetzungsfrage. Wer sie erst nach der Systementscheidung prüft, hat nur noch Behelfslösungen zur Wahl.
Klären Sie den Datenzugriff vor der Systementscheidung
Über Datenqualität wird in ERP-Auswahlprojekten inzwischen selbstverständlich gesprochen. Stammdatenpflege, Dublettenfreiheit, Verantwortlichkeiten, Migrationsstrategie. Das ist richtig, und es ist mühsam genug, dass es meist die volle Aufmerksamkeit bindet.
Deutlich seltener wird gefragt, wie die Daten später eigentlich wieder aus dem System herauskommen sollen. Diese Frage taucht typischerweise auf, wenn das System steht, der Betrieb läuft und der erste ernsthafte KI-Anwendungsfall gebaut werden soll. Dann ist sie keine Auswahlfrage mehr, sondern ein Umsetzungsproblem mit einem sehr begrenzten Lösungsraum.
Der Zeitpunkt ist deshalb ungünstig, weil sich an der Zugriffsart nachträglich wenig ändern lässt. Was ein Anbieter an Schnittstellen, Berechtigungslogik und Erweiterungsmechanismen mitbringt, ist Teil seines Produkts und nicht Gegenstand von Konfiguration. Wer damit unzufrieden ist, kann in der Regel zwischen zwei unangenehmen Optionen wählen: eine Behelfslösung bauen, die niemand langfristig betreiben will, oder auf den Anwendungsfall verzichten.
Dabei ist die Frage nicht neu und auch nicht durch KI entstanden. Reporting, Business Intelligence und Automatisierung brauchten immer schon Zugriff auf ERP-Daten. Was sich verändert hat, ist die Fallhöhe. Solange Daten für ein nächtliches Reporting exportiert wurden, war ein grober Weg ausreichend. Sobald eine Anwendung Vorgänge vorbereitet oder Aktionen auslöst, gelten andere Anforderungen.
Datenqualität und Datenzugriff sind zwei verschiedene Baustellen
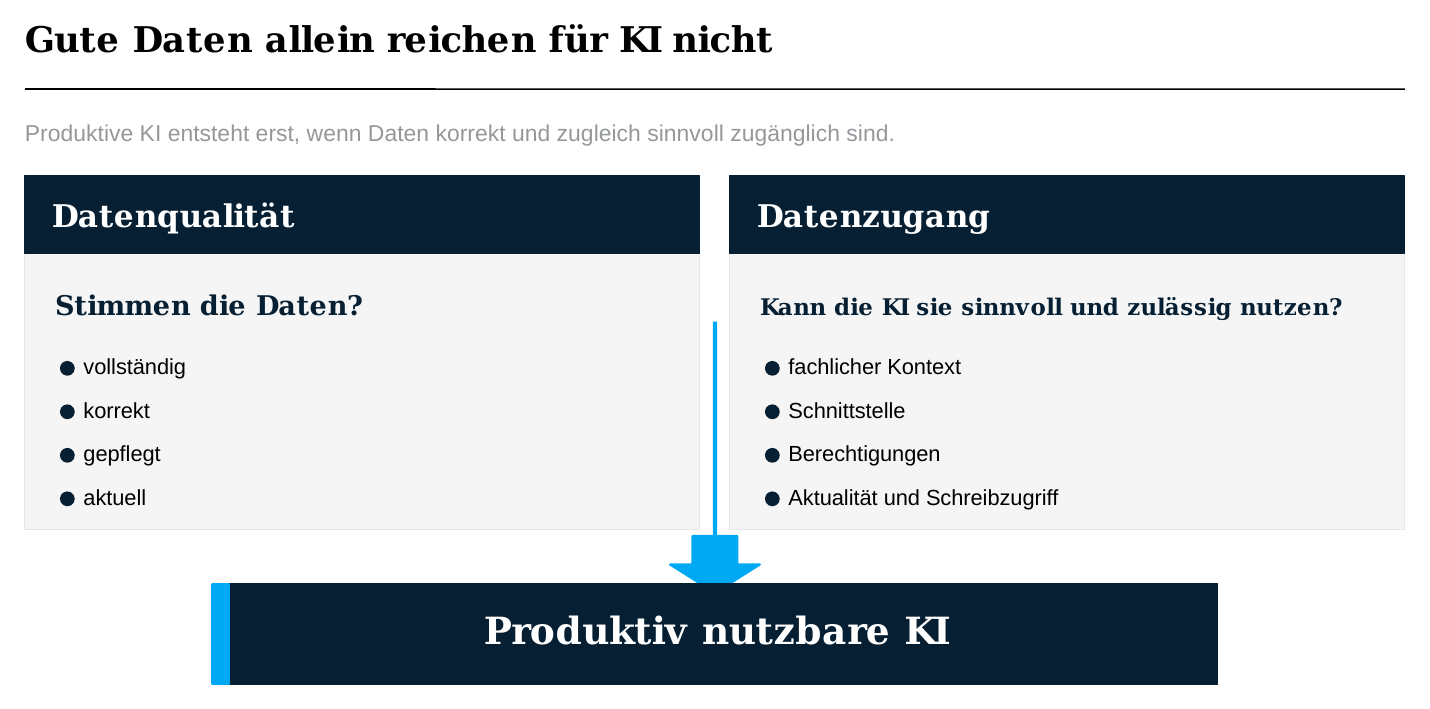
Die beiden Themen werden häufig in einen Topf geworfen, und das führt zu einem verbreiteten Missverständnis. Ein Unternehmen kann jahrelang an seinen Stammdaten arbeiten, Pflegeprozesse etablieren, Verantwortlichkeiten klären, und am Ende trotzdem feststellen, dass die KI-Anwendung nicht produktiv gehen darf.
Datenqualität beantwortet die Frage, ob die Daten stimmen. Datenzugriff beantwortet die Frage, ob und unter welchen Bedingungen jemand anderes mit ihnen arbeiten kann. Beides ist notwendig, und keines ersetzt das andere.
Die Marktzahlen zeigen, dass die Datenseite insgesamt als Engpass wahrgenommen wird. In der Lünendonk-Studie nennen 48 Prozent der IT-Entscheider schlechte Datenqualität als Hemmnis für generative KI, 54 Prozent fehlende Daten für das Modelltraining [1]. Was solche Zahlen nicht auflösen, ist die Frage, welcher Anteil davon tatsächlich Qualitätsprobleme sind und welcher Anteil schlicht Zugriffsprobleme. Nach unserer Beobachtung in Auswahl- und Umsetzungsprojekten ist der zweite Anteil größer, als die Formulierung „fehlende Daten“ vermuten lässt. Die Daten sind oft vorhanden. Sie sind nur nicht in einer Form erreichbar, mit der sich arbeiten lässt.
Die Stärke von ERP-Daten liegt in ihren Relationen
Der Wert eines ERP-Datenbestands entsteht weniger aus der Menge als aus den Beziehungen. Belege, Stammdaten, Buchungen und Prozesszustände sind über Fremdschlüssel miteinander verbunden, und das Datenbankschema erzwingt diese Verknüpfungen über referentielle Integrität. Genau darin liegt die fachliche Bedeutung: Die Beziehung sagt mehr aus als das einzelne Feld.
Ein Auftragskopf ohne seine Positionen ist ein Datensatz mit Kundennummer und Datum. Eine Buchung ohne Kostenstelle ist ein Betrag. Ein Beleg ohne den zugehörigen Geschäftspartner ist eine Nummer. Technisch sind das alles weiterhin Daten. Fachlich sind sie wertlos, weil die Aussage im Zusammenhang steckt und nicht im einzelnen Feld.
An diesem Punkt scheitern viele Zugriffslösungen. Sie liefern Tabellen, aber nicht die Semantik dazu. Ein Modell, das eine Tabelle mit dreißig Spalten und kryptischen Feldnamen erhält, kann daraus keine belastbaren Aussagen ableiten, unabhängig davon, wie leistungsfähig es ist. Es fehlt nicht an Rechenleistung, sondern an der Information, was diese Spalte bedeutet und mit welchen anderen Objekten sie zusammenhängt.
In der wissenschaftlichen Auseinandersetzung mit ERP-Datenarchitekturen tauchen deshalb regelmäßig dieselben drei Anforderungen auf: Interoperabilität, Verständlichkeit des Datenmodells und granulare Sicherheitsmechanismen [2]. Alle drei betreffen den Zugriff auf die Daten, nicht ihre Speicherung. Das ist eine bemerkenswerte Verschiebung gegenüber der klassischen Diskussion, in der es fast ausschließlich um Datenhaltung und Datenqualität ging.
Hinzu kommt ein struktureller Punkt, der in mittelständischen Landschaften besonders wirkt. Im typischen mittelständischen Unternehmen laufen rund 14 Business-Anwendungen nebeneinander, häufig schlecht dokumentiert und kaum integriert [3]. Der fachliche Kontext einer Information liegt damit oft nicht in einem System, sondern verteilt. Ein Auftrag im ERP, die Kundenhistorie im CRM, die Spezifikation im Dokumentenmanagement. Wer diesen Kontext für eine KI-Anwendung zusammenführen will, braucht aus jedem beteiligten System einen Zugang, der die fachliche Bedeutung mitliefert. Entsprechend nennen 73 Prozent der IT-Verantwortlichen mangelnde Systemkompatibilität als größte Integrationsbarriere, so eine von IDC erhobene und dort zitierte Zahl [3].
Je tiefer KI in Prozesse greift, desto höher die Zugriffsanforderungen
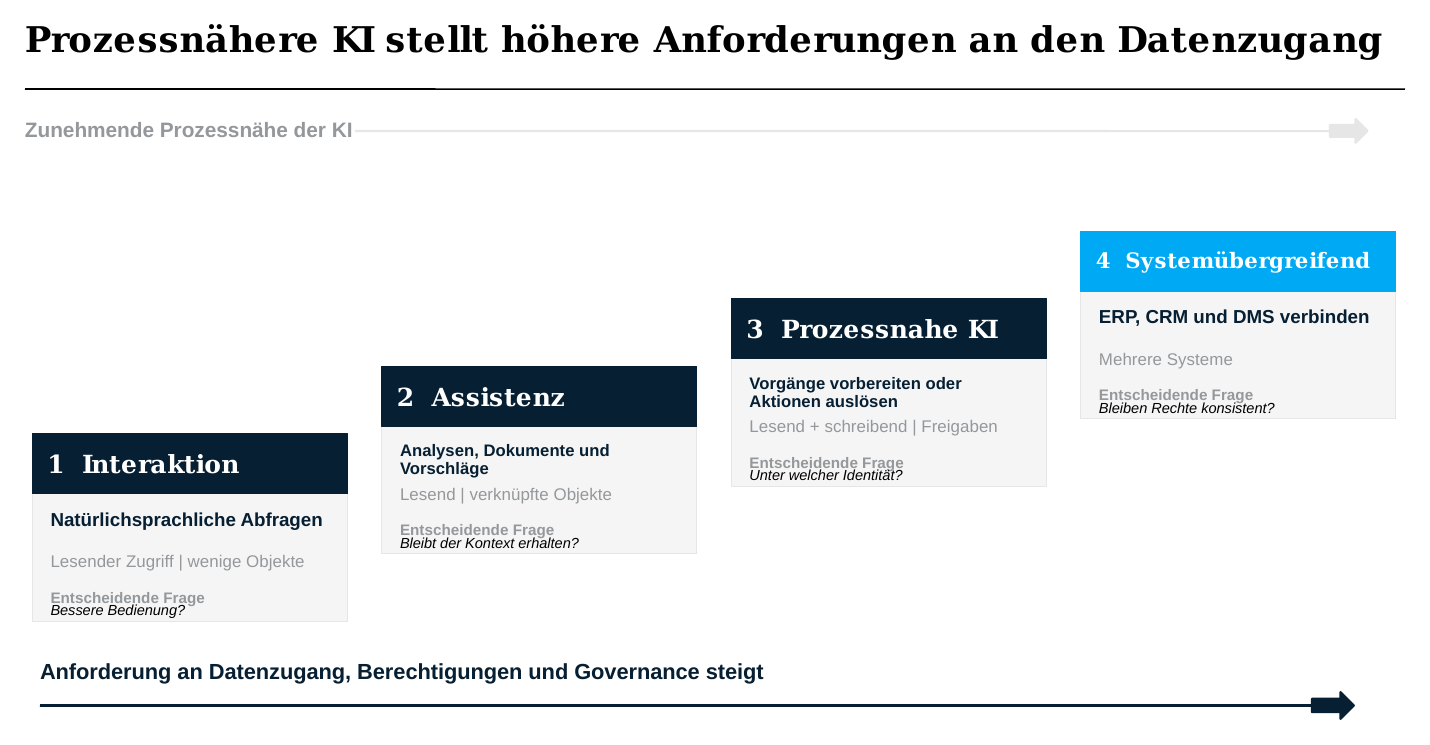
Unter dem Begriff KI werden sehr unterschiedliche Einsatzformen zusammengefasst, und sie stellen sehr unterschiedliche Anforderungen an den Datenzugriff. Es lohnt sich, vier Ebenen zu unterscheiden, weil auf jeder eine andere Frage über Erfolg oder Scheitern entscheidet.
Ebene 1, Interaktion mit dem System. Natürlichsprachliche Abfragen, Suche, vereinfachte Bedienung. Der Zugriff ist lesend und beschränkt sich meist auf Objekte, die der Nutzer ohnehin sehen darf. Diese Ebene funktioniert häufig auch dann, wenn die Anbindung eher grob ist, weil der Assistent innerhalb der Anwendung läuft und deren Kontext erbt.
Ebene 2, Unterstützung einzelner Funktionen. Dokumente auslesen, Analysen vorbereiten, Auffälligkeiten erkennen, Bearbeitungsschritte vorschlagen. Der Klassiker ist die Eingangsrechnung, die ausgelesen und gegen Bestellung und Stammdaten abgeglichen wird. Hier braucht die Anwendung bereits Zugriff über mehrere Objekttypen hinweg, und die Ergebnisse hängen unmittelbar davon ab, ob der Zusammenhang zwischen ihnen erkennbar ist. Ein Abgleich gegen Stammdaten funktioniert nur, wenn die Anwendung weiß, welche Stammdaten zu diesem Lieferanten gehören.
Ebene 3, prozessnahe KI. Die Anwendung bereitet Prozessschritte vor, löst definierte Aktionen aus oder übernimmt Teile einer Bearbeitung. Ab hier ist der Zugriff nicht mehr nur lesend, und damit ändert sich die Bewertung grundlegend. Es geht um Freigabemechanismen, um Protokollierung, um die Frage, unter wessen Identität eine Aktion ausgeführt wird und wer sie im Zweifel verantwortet. Ob eine KI eine Aufgabe technisch ausführen kann, ist auf dieser Ebene die kleinere Frage.
Ebene 4, systemübergreifende KI. Daten und Funktionen aus ERP, CRM, Dokumentenmanagement und Fachanwendungen werden kombiniert. Jetzt zählt nicht mehr die Qualität eines einzelnen Zugangs, sondern die der gesamten Architektur. Berechtigungen müssen über Systemgrenzen hinweg konsistent sein, sonst entsteht genau die Lücke, die niemand verantworten will: Ein Nutzer sieht über die KI kombiniert, was ihm in keinem der beteiligten Systeme einzeln zugänglich wäre.
| Ebene | Zugriffsart | Die Frage, die hier entscheidet |
|---|---|---|
| 1 Interaktion | lesend, wenige Objekte | Ist die Bedienung wirklich besser? |
| 2 Funktionsunterstützung | lesend, mehrere Objekttypen | Kommt der fachliche Zusammenhang mit? |
| 3 Prozessnah | schreibend, mit Freigaben | Unter welcher Identität handelt die KI? |
| 4 Systemübergreifend | lesend und schreibend, mehrere Systeme | Sind die Rechte über Systemgrenzen konsistent? |
Der praktische Nutzen dieser Unterscheidung liegt in der Auswahl. Ein Anbieter, der einen integrierten Assistenten vorführt, hat Ebene 1 gezeigt. Über die Eignung für Ebene 3 sagt diese Demonstration wenig aus. Wer beides gleichsetzt, kauft eine Fähigkeit, die er nicht bekommen hat.
Vier Zugriffsarten, vier Governance-Profile
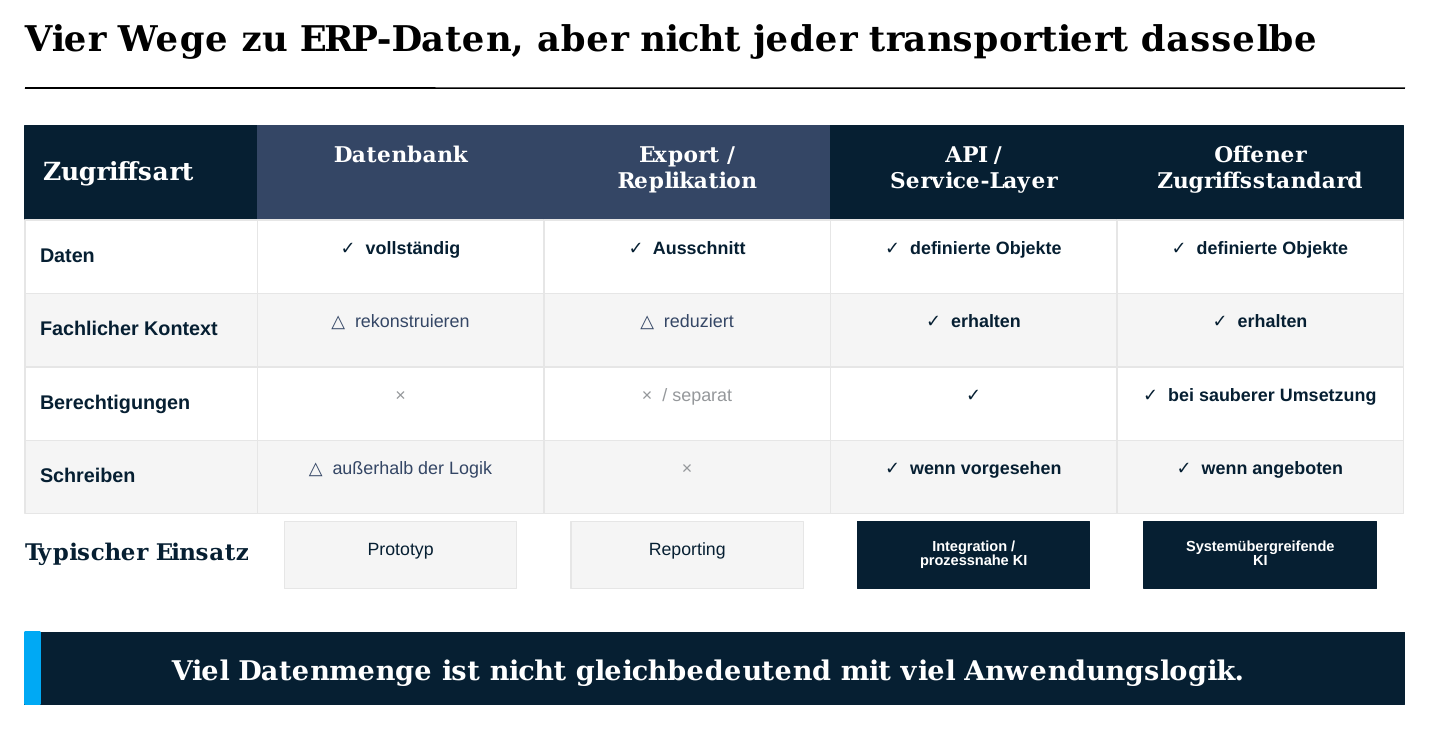
In der Praxis begegnen einem im Wesentlichen vier Zugriffsarten. Sie unterscheiden sich weniger darin, was technisch möglich ist, als darin, was von der Anwendungslogik erhalten bleibt.
| Zugriffsart | Kurzcharakterisierung |
|---|---|
| Direkter Datenbankzugriff | Rohdaten vollständig, ohne Rechte und ohne Prozesslogik |
| Export und Replikation | Definierte Ausschnitte, planbar, aber nicht aktuell und ohne Rückweg |
| API und Service-Layer | Fachliche Objekte mit Berechtigungen, begrenzt auf das Vorgesehene |
| Offener Zugriffsstandard | Fachliche Objekte mit Berechtigungen, auch für Anwendungen Dritter |
Keiner dieser Wege ist grundsätzlich richtig oder falsch. Für ein nächtliches Reporting ist eine Replikation oft genau das Passende, und ein Data Warehouse über einen Service-Layer zu befüllen wäre unnötig aufwendig. Die Bewertung verschiebt sich erst mit der Prozessnähe.
Direkter Datenbankzugriff
Der Zugriff über die Datenbank wirkt zunächst attraktiv. Er ist schnell eingerichtet, unabhängig vom Anbieter und liefert alles. Genau darin liegt das Problem.
Die Rechte- und Rollenlogik eines ERP-Systems liegt nicht in der Datenbank, sondern in der Anwendung darüber. Wer an der Anwendung vorbei zugreift, umgeht sie vollständig. Eine so angebundene KI sieht Personaldaten genauso wie Einkaufskonditionen und Deckungsbeiträge, unabhängig davon, wer die Frage gestellt hat. Dieselbe Anwendung, die dem Vertriebsmitarbeiter beim Angebot hilft, kann ihm auf Nachfrage die Gehaltsliste vorlesen.
Für einen Prototypen ist das oft vertretbar, weil der Nutzerkreis klein und kontrolliert ist. Für den produktiven Einsatz reicht es in den meisten Unternehmen nicht, und zwar aus einem sehr praktischen Grund: Der Fachbereich kann die Nutzung nicht verantworten. Wer den Datenschutzbeauftragten fragt, ob eine Anwendung ohne Berechtigungsprüfung auf den kompletten Personalstamm zugreifen darf, bekommt eine erwartbare Antwort.
Dazu kommt die Wartungsfrage. Ein Datenmodell ist kein stabiles Interface. Es ändert sich mit Releases, Felder werden umbenannt, Tabellen umstrukturiert. Jede solche Änderung bricht die Anbindung, und niemand informiert vorher darüber, weil der Anbieter von dieser Nutzung nichts weiß. In der Praxis führt das zu Anwendungen, die nach einem Update stillschweigend falsche Ergebnisse liefern, was schlimmer ist als ein sichtbarer Ausfall.
Export und Replikation
Der klassische Weg für Auswertungen. Daten werden über eine ETL-Strecke in definierten Intervallen in ein Zielsystem gespiegelt, meist ein Data Warehouse oder einen Analysebereich. Der Vorteil liegt in der Planbarkeit und darin, dass die Last vom Produktivsystem genommen wird.
Für KI-Anwendungen taugt dieser Weg nur begrenzt. Der Zugriff ist einseitig, die Daten sind so aktuell wie der letzte Lauf, und die Übertragung reduziert den fachlichen Zusammenhang häufig auf das, was die Zielstruktur vorsieht. Was im Zielsystem ankommt, ist eine Auswertungssicht und nicht das Geschäftsobjekt.
Solange KI Auswertungen unterstützt, ist das unproblematisch. Sobald sie in laufende Vorgänge eingreifen soll, fehlen sowohl die Aktualität als auch der Rückweg.
API und Service-Layer
Der Weg, den die meisten modernen Systeme vorsehen. Der Anbieter stellt über REST oder OData fachliche Objekte bereit, Aufträge, Belege, Partner, Bewegungen, und der Zugriff läuft über die Anwendungslogik. Damit greifen Validierungen, Berechtigungen und Protokollierung wie bei einem normalen Nutzer.
Der Preis dafür ist eine Beschränkung auf das, was der Anbieter vorgesehen hat. Ist ein Objekt nicht ansprechbar, gibt es keinen Umweg, außer man verlässt den Weg wieder. Für die Auswahl heißt das: Die Frage lautet nicht, ob eine API existiert, sondern welcher Ausschnitt des Systems darüber erreichbar ist.
Diese Verlagerung ist Teil einer breiteren Entwicklung. Wo Anpassungen früher am ERP-Kern vorgenommen wurden, verschieben sie sich zunehmend auf Schnittstellen und Integration, besonders bei Cloud-Systemen [4]. Was früher eine Modifikation war, ist heute eine Integration. Damit wird die Qualität der Schnittstellen zu dem, was die Modifizierbarkeit des Kerns früher war: der Faktor, der bestimmt, wie weit sich ein System an das Unternehmen anpassen lässt.
Offene Zugriffsstandards
Mit dem Model Context Protocol hat sich ein offener Standard etabliert, über den KI-Anwendungen auf externe Systeme zugreifen können [5]. Der unmittelbare Effekt ist unspektakulär: Statt für jede Kombination aus Modell und System eine eigene Anbindung zu bauen, gibt es eine einheitliche Art, Daten und Funktionen bereitzustellen.
Interessanter ist die zweite Wirkung. Ein sauber gebauter Zugang dieser Art legt fachliche Objekte offen, nicht Tabellen, und er kann die Berechtigungen des aufrufenden Nutzers mitführen. Damit lässt sich erreichen, was der Datenbankweg gerade verhindert: Zugriff mit Kontext und mit Rechten.
Was ein Standard nicht leistet, ist eine Aussage über die Umsetzungsqualität. Ein Zugang, der im Hintergrund doch nur Tabellen durchreicht und alle Nutzer gleich behandelt, trägt das Etikett, aber nicht die Eigenschaft. Die Frage im Auswahlprozess lautet deshalb nicht, ob ein Anbieter den Standard unterstützt, sondern was auf diesem Weg tatsächlich sichtbar wird und für wen.
Governance entscheidet vor der Technik
Bei prozessnahen Anwendungen verschiebt sich die Diskussion von der Technik zur Verantwortung. Vier Fragen entscheiden dann darüber, ob eine Anwendung produktiv gehen darf.
Wer sieht was? Die Berechtigungen des anfragenden Nutzers müssen gelten, und zwar zeilen- und feldgenau. Was in der Datenbankwelt Row-Level Security heißt, ist im ERP die Kombination aus Rollen, Organisationseinheiten und Feldberechtigungen. Sie muss auch dann greifen, wenn die KI Informationen aus mehreren Objekten kombiniert. Eine Aggregation kann Rückschlüsse erlauben, die der Einzelzugriff nicht zulässt.
Unter wessen Identität wird gehandelt? Sobald eine Anwendung schreibt, braucht es eine eindeutige Antwort. Ein technischer Sammelnutzer mit weitreichenden Rechten, im Betrieb oft schlicht Service-Account genannt, ist der bequeme Weg und zugleich der, der jede Nachvollziehbarkeit zerstört.
Was wird protokolliert? Eine Freigabe, die auf einem KI-Vorschlag beruht, muss später rekonstruierbar sein. Dazu gehört nicht nur, dass etwas passiert ist, sondern auf welcher Datengrundlage.
Wozu dürfen die Daten genutzt werden? Die Zweckbindung gilt auch dann, wenn Daten das System über eine technisch saubere Schnittstelle verlassen. Ein Zugang, der alles ermöglicht, verlagert diese Frage nur an eine andere Stelle.
Diese vier Punkte sind der Grund, warum Governance in der Praxis vor der Technik entscheidet. Eine Zugriffsart, die die Antworten nicht mitliefert, muss sie an anderer Stelle nachbauen, und das ist teuer.
Der Anbieter hat eigene Interessen, und das ist legitim
Ein Punkt, der in der Diskussion um offene Datenzugänge gerne ausgespart wird: Anbieter haben ein eigenes Interesse an dem Datenbestand, der in ihrem System liegt. Er ist die Grundlage für eigene Auswertungs- und KI-Angebote, teilweise auch für Benchmarks über die Kundenbasis hinweg.
Das ist kein Vorwurf. Es bedeutet aber, dass Datenzugriff ein Thema ist, bei dem sich Anwender- und Anbieterinteressen nicht automatisch decken. Ein Anbieter, der Daten ausschließlich über eigene Werkzeuge zugänglich macht, verfolgt eine nachvollziehbare Produktstrategie. Für den Anwender entsteht daraus eine Abhängigkeit, die er kennen und bewerten sollte, bevor er sich festlegt.
Absehbar ist, dass sich auch die Lizenzmodelle in diese Richtung entwickeln. Wenn der Wert eines Systems zunehmend darin liegt, dass andere Anwendungen darauf zugreifen, wird die Frage relevant, ob und wie dieser Zugriff bepreist wird. Aus Anwendersicht gehört das in die Wirtschaftlichkeitsbetrachtung, und zwar zum Zeitpunkt der Auswahl. Aus Anbietersicht muss über neue und veränderte Formen der Lizenzierung nachgedacht werden dürfen. Beides sind berechtigte Positionen, und beide sollten offen auf dem Tisch liegen.
KI-Prototypen scheitern am Übergang in den Betrieb
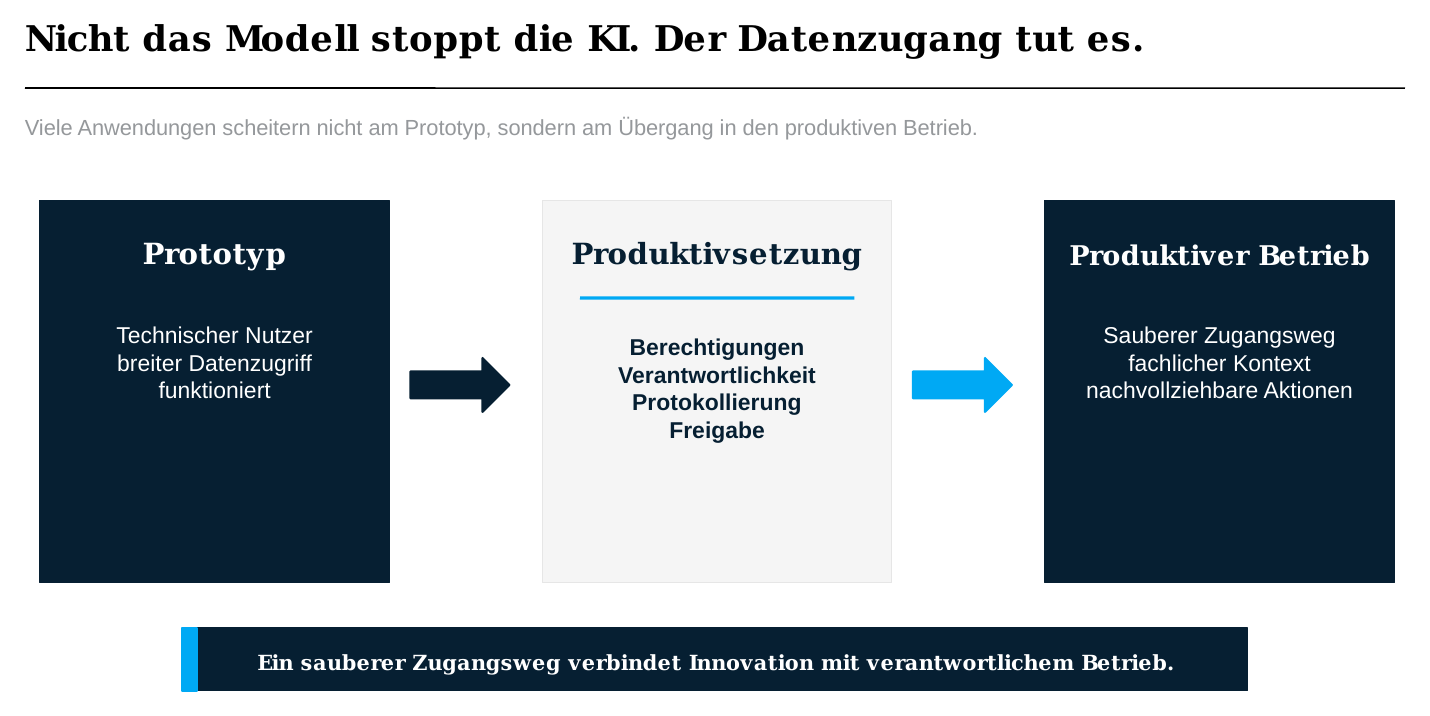
Die Beobachtung aus den vergangenen Monaten ist recht eindeutig: Ein erheblicher Teil der selbst entwickelten KI-Anwendungen kommt über den Prototypenstatus nicht hinaus. Meist liegt das nicht an der Idee, und auch nicht am Modell. Der Prototyp funktioniert, oft überraschend gut, weil er auf einem Weg gebaut wurde, der für einen Prototypen genügt.
Der Bruch kommt bei der Überführung in den Betrieb. Dann stellt sich heraus, dass der Zugriff so nicht freigegeben wird, dass die Berechtigungen fehlen, dass niemand die Verantwortung für einen technischen Nutzer mit Vollzugriff übernehmen will. An dieser Stelle endet die Entwicklung, und die Lösung bleibt bei den wenigen Anwendern hängen, die sie gebaut haben.
Dass der Engpass selten in der Technologie liegt, zeigt auch die Aufteilung des Wertbeitrags. Die 10-20-70-Regel beschreibt dieses Verhältnis: Rund zehn Prozent des Wertbeitrags entstehen durch Algorithmen, zwanzig Prozent durch Technologie und Datenstack, siebzig Prozent durch Menschen, Prozesse und Organisation [6]. Die Zugriffsart liegt genau an der Nahtstelle zwischen den zwanzig und den siebzig Prozent. Sie ist technisch, entscheidet aber darüber, ob die organisatorische Seite überhaupt zustimmen kann.
Für die Auswahl folgt daraus eine unbequeme Empfehlung: Der interessanteste Anwendungsfall sollte nicht der sein, der sich am schnellsten prototypisch bauen lässt, sondern der, für den der Zugriff sauber freigegeben werden kann.
Was Sie beim Anbieter konkret erfragen sollten
Sechs Fragen, die sich in einer Anbieterpräsentation stellen lassen und deren Antworten sich zwischen Anbietern deutlich unterscheiden.
Über welchen Weg greifen KI-Komponenten auf Daten zu? Eine gute Antwort benennt den Mechanismus und seine Grenzen. Wenn die Antwort im Kern „über die Datenbank“ lautet, ist die Governance-Frage damit gestellt und noch nicht beantwortet.
Werden die Berechtigungen des Nutzers mitgeführt? Die entscheidende Nachfrage lautet, ob ein Anwender über die KI Daten sehen kann, die ihm in der Oberfläche verwehrt wären. Bei dieser Frage trennt sich in Präsentationen erfahrungsgemäß die Spreu vom Weizen.
Welche fachlichen Objekte sind ansprechbar und welche nicht? Ein Zugang, der Stammdaten kennt, aber keine Belege und keine Bewegungsdaten, deckt die meisten interessanten Anwendungsfälle nicht ab. Lassen Sie sich die Liste zeigen, nicht das Prinzip erklären.
Ist der Zugriff lesend oder auch schreibend? Sobald KI Vorgänge anlegt oder ändert, gelten Freigabe- und Protokollierungsanforderungen. Klären Sie, welche Aktionen möglich sind und wie sie im Audit-Trail erscheinen.
Wie stabil ist der Zugang über Releases hinweg? Eine dokumentierte und versionierte Schnittstelle mit Ankündigungsfristen ist etwas anderes als ein Zugriff, der nach jedem Update neu geprüft werden muss. Fragen Sie nach der Deprecation-Politik, also danach, wie lange eine abgekündigte Schnittstellenversion noch bedient wird.
Können auch andere Anwendungen diesen Weg nutzen? Ein Zugang, der ausschließlich den hauseigenen Assistenten bedient, ist ein Feature. Ein offener Zugang ist eine Architekturentscheidung. Der Unterschied zeigt sich erst in dem Moment, in dem Sie eine spezialisierte Anwendung anbinden wollen.
Bei den Antworten lohnt sich Genauigkeit. Der Unterschied zwischen „wir haben eine API“ und „unsere Schnittstelle führt Berechtigungen und fachliche Semantik mit und ist über Releases hinweg versioniert“ entscheidet darüber, was in drei Jahren möglich sein wird.
Dass diese Fähigkeit an Bedeutung gewinnt, sehen die IT-Verantwortlichen selbst so. In der Lünendonk-Studie erwarten 72 Prozent der befragten CIOs und IT-Leiter, dass Integrationsfähigkeit bis 2030 zur Kernkompetenz der eigenen IT wird [1].
Was Sie im eigenen Haus klären müssen
Der Anbieter liefert die Möglichkeit. Ob sie genutzt wird, entscheidet sich intern, und dort sind drei Punkte zu klären, bevor der erste Anwendungsfall startet.
Wer entscheidet über Datenzugriffe? In vielen Unternehmen ist das ungeklärt, solange es nur um Reporting geht. Sobald externe Anwendungen zugreifen, braucht es eine benannte Stelle, die Zugriffe freigibt und dokumentiert.
Wie weit reicht die eigene Integrationskompetenz? Ein Unternehmen mit eigener Entwicklungs- und Integrationsmannschaft kann spezialisierte Anwendungen anders betreiben als eines, das bewusst möglichst viele Leistungen aus einer zentralen Lösung bezieht. Beides ist legitim, und beides führt zu unterschiedlichen Anforderungen an die Anbindung.
Welche Anwendungsfälle rechtfertigen den Aufwand? Ein sauberer Zugang ist Arbeit. Diese Arbeit lohnt sich dort, wo sie mehrere Anwendungsfälle trägt, und selten für einen einzelnen. Die Priorisierung sollte deshalb nicht beim spektakulärsten Anwendungsfall beginnen, sondern beim Datenbereich mit der größten Wiederverwendung.
Fazit
Datenqualität und Datenzugriff sind zwei verschiedene Themen, und in Auswahlprojekten wird meist nur das erste behandelt. Dabei entscheidet die Art des Zugriffs darüber, ob aus einem gepflegten Datenbestand überhaupt Nutzen entsteht.
Für die Systemauswahl heißt das: Der Datenzugriff gehört auf dieselbe Ebene wie funktionale Passung und Branchentiefe. Er ist keine Detailfrage der späteren Umsetzung, sondern eine Produkteigenschaft, die man mit der Entscheidung bekommt oder eben nicht. Und er lässt sich, anders als fast alles andere im Projekt, nachträglich kaum korrigieren.
Wer heute auswählt, sollte deshalb neben der Frage, was ein System kann, eine zweite stellen: Was können andere Anwendungen künftig mit den Daten dieses Systems machen, und unter welchen Bedingungen. Wie sich daraus belastbare Anforderungen ableiten lassen, ist ein eigenes Thema.
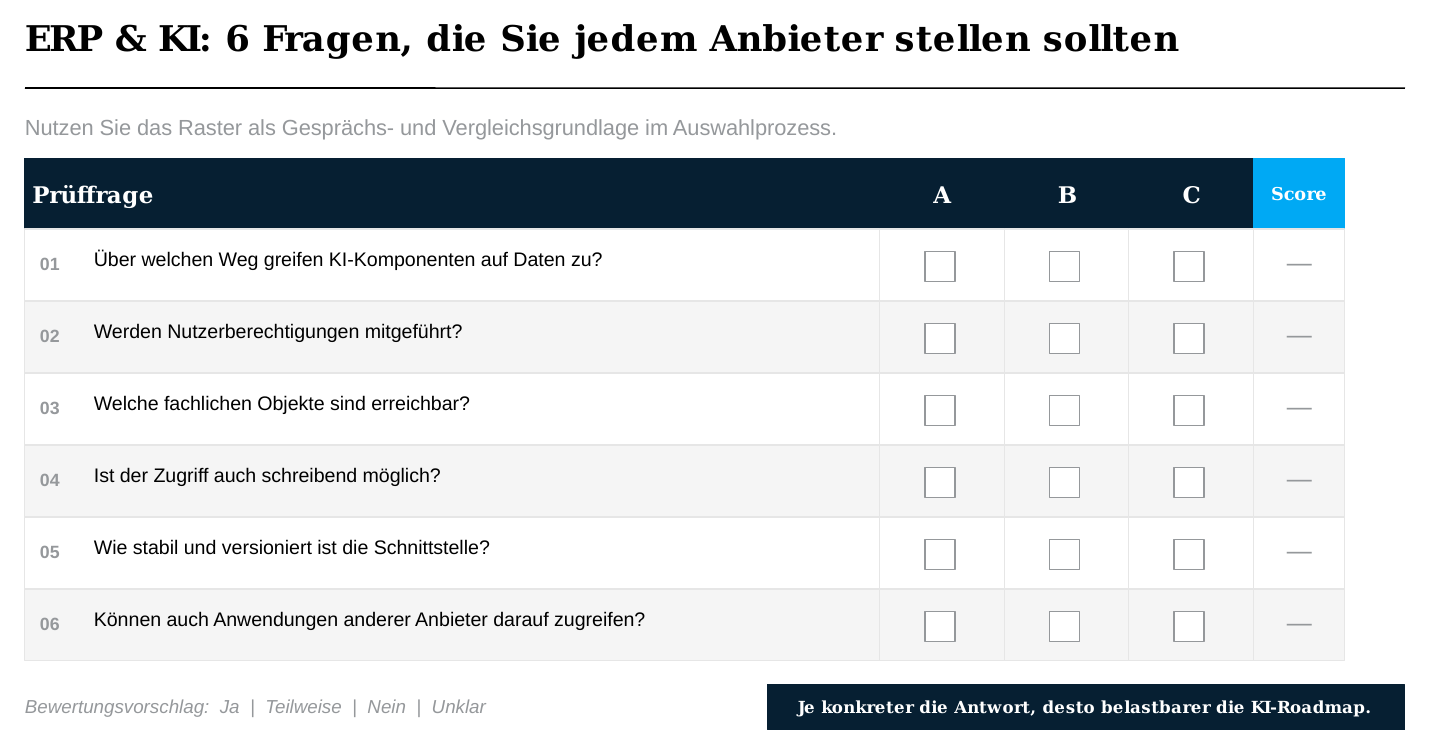
Bewertungsraster: Datenzugriff im Anbietergespräch
Sechs Fragen für das Anbietergespräch, die über den späteren KI-Einsatz entscheiden, mit Bewertungsraster für bis zu drei Anbieter und einer Einordnung der Antworten. Damit vergleichen Sie Antworten, statt sie zu erinnern.
Häufige Fragen
Sie ist die Voraussetzung, aber kein Nachweis. Entscheidend sind drei Eigenschaften: ob fachliche Objekte statt Tabellen bereitgestellt werden, ob die Berechtigungen des Nutzers mitgeführt werden und ob die Schnittstelle über Releases hinweg stabil und versioniert bleibt. Eine API ohne diese Eigenschaften verlagert das Problem nur.
Die Rechte- und Rollenlogik eines ERP-Systems liegt in der Anwendung, nicht in der Datenbank. Ein direkter Zugriff umgeht sie vollständig, sodass die Anwendung unabhängig vom fragenden Nutzer alle Daten sieht. Dazu kommt, dass sich das Datenmodell mit Releases ändert und die Anbindung dann unbemerkt falsche Ergebnisse liefern kann. Für Prototypen ist der Weg oft akzeptabel, für den produktiven Betrieb in den meisten Unternehmen nicht.
Das Model Context Protocol ist ein offener Standard, über den KI-Anwendungen auf externe Systeme zugreifen. Für die Auswahl ist weniger die Unterstützung des Standards interessant als die konkrete Umsetzung: welche fachlichen Objekte darüber sichtbar werden, ob Nutzerberechtigungen mitgeführt werden und ob der Zugang auch für Anwendungen außerhalb des Anbieterportfolios offensteht.
Vor der Entscheidung, gemeinsam mit der funktionalen Bewertung. Die Zugriffsart ist eine Produkteigenschaft und lässt sich nachträglich kaum verändern. Wer die Frage in die Umsetzungsphase verschiebt, hat dann nur noch die Wahl zwischen Behelfslösungen und Verzicht auf den Anwendungsfall.
Nein. Wer seine Prozesse überwiegend in einer zentralen Lösung abbildet und keine eigene Integrationskompetenz aufbauen will, kommt mit den Bordmitteln des Anbieters weit. Die Frage ist, ob diese Entscheidung bewusst getroffen wurde oder sich aus einer nicht gestellten Frage ergeben hat.
Weil ein Prototyp mit einer Anbindung auskommt, die der Betrieb nicht zulässt. Häufig läuft er über einen technischen Nutzer mit weitreichenden Rechten. In der Freigabe stellt sich dann heraus, dass niemand die Verantwortung dafür übernehmen kann, und die Anwendung bleibt bei den wenigen Anwendern hängen, die sie gebaut haben.
Auf den unteren Ebenen genügt lesender Zugriff auf Objekte, die der Nutzer ohnehin sehen darf. Sobald KI Vorgänge vorbereitet oder auslöst, kommen schreibender Zugriff, Freigabemechanismen, Protokollierung und die Frage der handelnden Identität hinzu. Bei systemübergreifenden Anwendungen müssen die Berechtigungen zusätzlich über Systemgrenzen hinweg konsistent sein.
Den Datenzugriff Ihrer Kandidatensysteme einmal sauber prüfen.
30 Minuten, unverbindlich. Wir schauen uns an, welche Zugriffsarten Ihre engere Auswahl tatsächlich bietet und was davon für Ihre geplanten Anwendungsfälle reicht.
Quellen
[1] Lünendonk & Hossenfelder (2025): Lünendonk-Studie 2025: IT-Sourcing-Trends 2025/2026. luenendonk.de https://www.luenendonk.de/produkt/luenendonk-studie-2025-it-sourcing-trends-2025-2026/
[2] Bender, B.; Bertheau, C.; Körppen, T.; Lauppe, H.; Gronau, N. (2022): A proposal for future data organization in enterprise systems. Information Systems and e-Business Management 20, S. 441–494. https://doi.org/10.1007/s10257-022-00555-6
[3] Brixon Group (2025): Buy-and-Build: Digitale Synergiehebel für maximalen ROI bei Unternehmensübernahmen. brixongroup.de https://brixongroup.de/buy-and-build-digitale-synergien-roi-2025
[4] Abendroth, A.; Bender, B.; Gronau, N. (2024): The Evolution of Original ERP Customization: A Systematic Literature Review of Technical Possibilities. SciTePress, ICEIS 2024, S. 17–27. https://doi.org/10.5220/0012305500003690
[5] Model Context Protocol (2026): What is the Model Context Protocol (MCP)? modelcontextprotocol.io https://modelcontextprotocol.io
[6] Boston Consulting Group (2025): The Widening AI Value Gap: Build for the Future 2025. bcg.com https://media-publications.bcg.com/The-Widening-AI-Value-Gap-Sept-2025.pdf